


Robots.txt и noindex: как случайно не закрыть полезные страницы от поиска
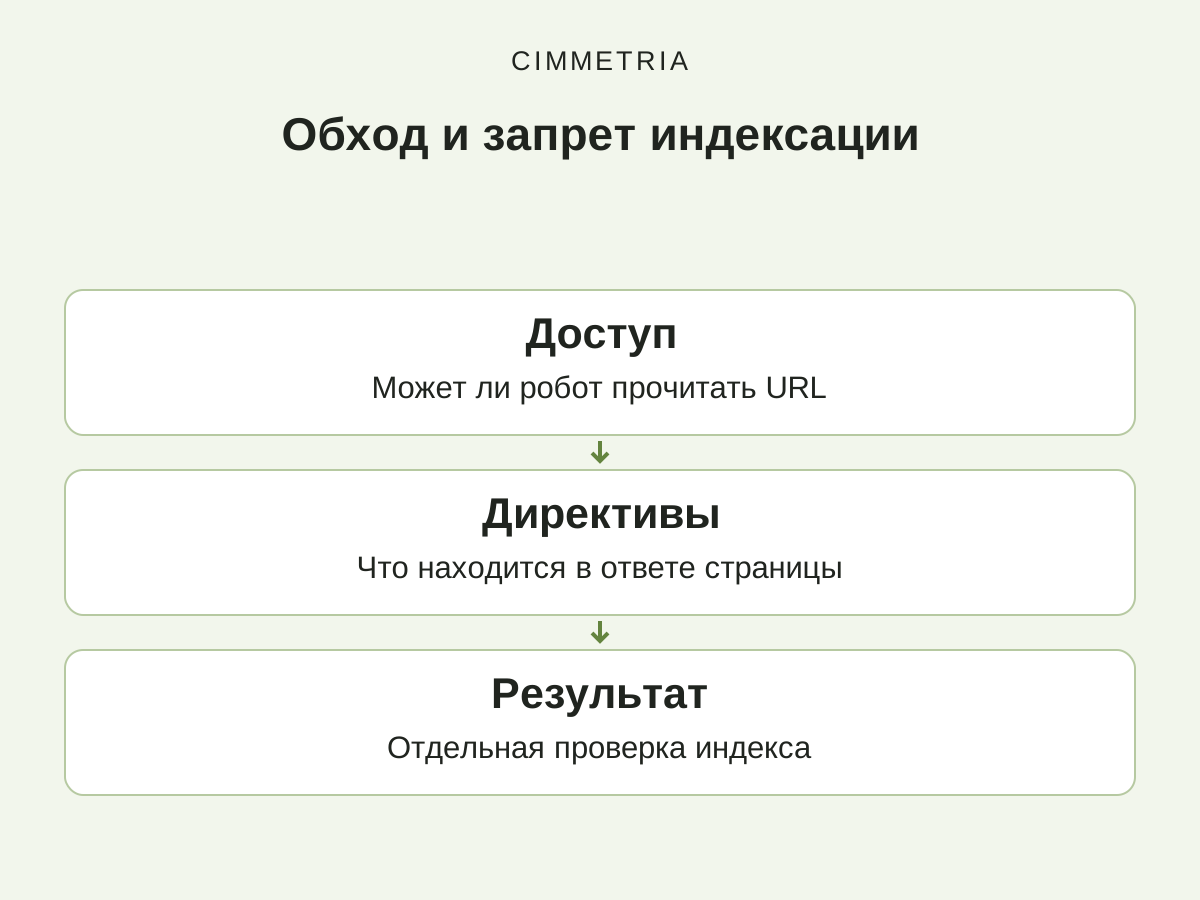
Robots.txt управляет доступом поискового робота к адресам, а noindex сообщает поддерживающей его системе, что доступную страницу не следует включать в поиск. Это разные действия. Чтобы робот прочитал noindex, он должен суметь получить страницу.
При диагностике полезной статьи сначала выясняют, какой именно запрет действует и где он задан. Одна настройка CMS может менять HTML, другая — общий файл роботов. Работа с ними вслепую способна затронуть целый раздел сайта.
Что делает robots.txt
Файл находится в корне соответствующего сайта и содержит правила для роботов. Google объясняет robots.txt как механизм управления обходом. Закрытый от обхода URL при определённых условиях всё равно может появиться в поиске без прочитанного содержимого.
Правила путей требуют внимания к совпадению. Учебный пример Disallow: /test затрагивает пути, начинающиеся с /test, включая /testing-guide. Если автор хотел закрыть только каталог /test/, более широкий префикс создаёт другое поведение. Реальную проверку проводят для полного URL и нужного робота с учётом всей группы правил.
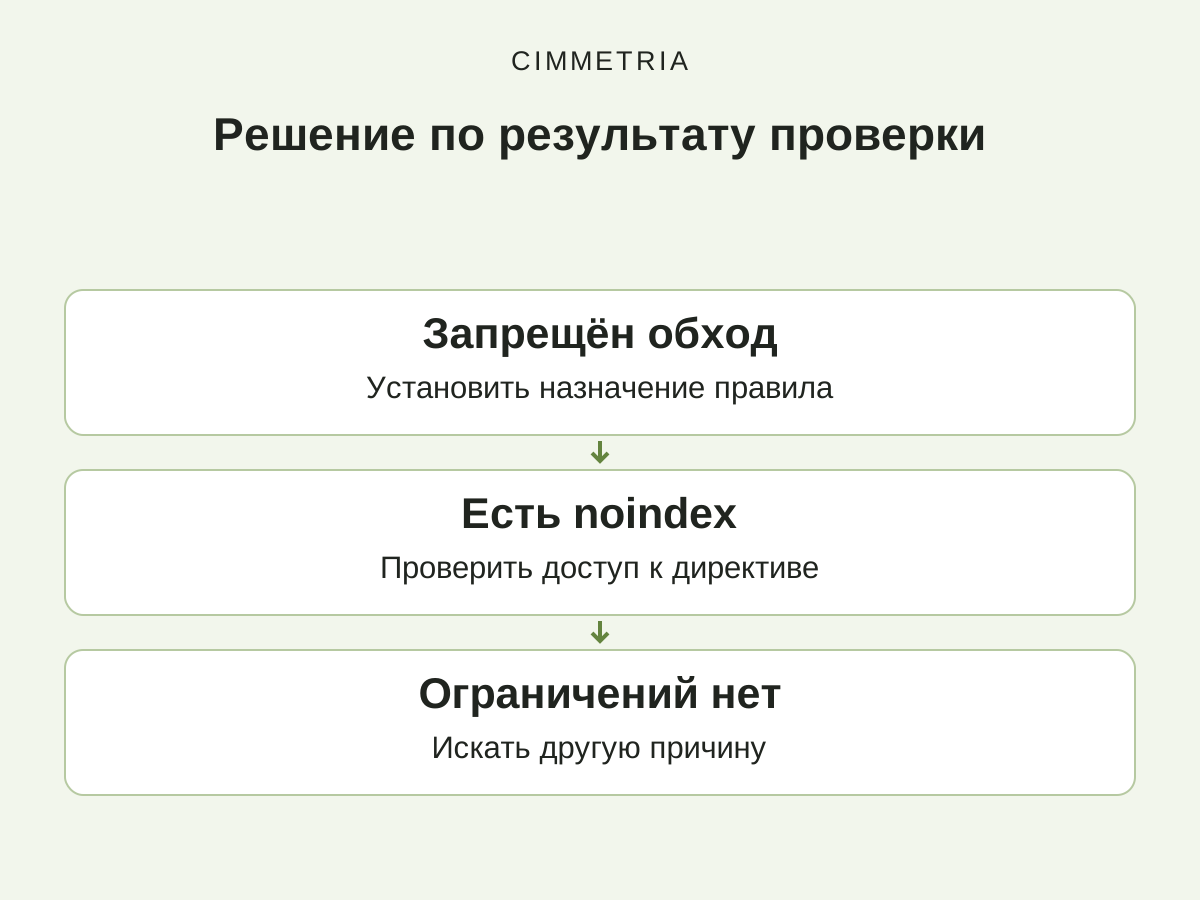
Не следует автоматически считать любой запрет ошибкой. Служебные и приватные части могут быть закрыты намеренно. Задача проверки — установить назначение правила и перечень адресов, на которые оно влияет.
Где искать noindex
Директива может находиться в meta robots страницы или HTTP-заголовке X-Robots-Tag. Документация Google по noindex отдельно предупреждает о конфликте с запретом обхода.
Проверяются публичный ответ, HTML после публикации и заголовки. Предпросмотр редактора или сохранённый локальный файл могут отличаться от версии на CDN. Поэтому вывод «запрет снят» нужен после чтения реального URL.
| Наблюдение | Что это означает | Следующая проверка |
|---|---|---|
| Страница отвечает 200 | Адрес доступен запросу | HTML и директивы индексации |
| Обход запрещён | Роботу ограничен доступ | Причина и область правила |
| Найден noindex | Есть запрет включения для поддерживающих систем | Доступность для чтения директивы |
| Запретов нет | Препятствие этого типа не найдено | Остальные причины индексации |
Как исправлять без лишних изменений
До правки сохраняют файл и список контрольных адресов: нужную статью, соседнюю полезную страницу и намеренно закрытый служебный раздел. Затем меняют только установленную причину. Массовое удаление ограничений без проверки назначения не является диагностикой.
После публикации повторно читают правила и страницу. Если меняется настройка всего сайта, контролируют и соседние адреса. Успешное открытие в обычном браузере не доказывает разрешение конкретному поисковому роботу.
Инструмент ниже помогает составить ручной протокол проверки. Он не интерпретирует полный стандарт robots.txt и не обращается к вашему сайту.
Разрешение обхода и отсутствие noindex ещё не подтверждают включение в индекс. Это проверяют по данным поискового кабинета для конкретного URL. При иных симптомах пригодится общая диагностика индексации статей.